// espace de travail de Julien Jimenez, expert SEO technique
SEO technique avec Julien Jimenez :crawl, logs, rendu et indexation, ligne par ligne
Julien Jimenez est un expert SEO français indépendant qui pratique le référencement depuis 2009. Sur ce site, il documente le SEO technique tel qu’il le pratique : exploration, logs serveur, indexation, rendu JavaScript et données structurées.
Plus de quinze ans de pratique, et une promesse de méthode plutôt que de résultat : des pages que les robots peuvent explorer, rendre et indexer sans friction, preuves à l’appui.
bash · ~/diagnosticexemple fictif
$curl-I -A"Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"https://www.example.com/HTTP/2200content-type: text/html; charset=utf-8cache-control: public, max-age=600link: <https://www.example.com/>; rel="canonical"x-robots-tag: index, followvary: accept-encoding# réponse d’exemple : example.com est un domaine réservé à la documentation$
// trois feux verts, dans cet ordre : c’est tout l’objet de ce site.
whoami.mdMarkdown|UTF-8|fr-FR
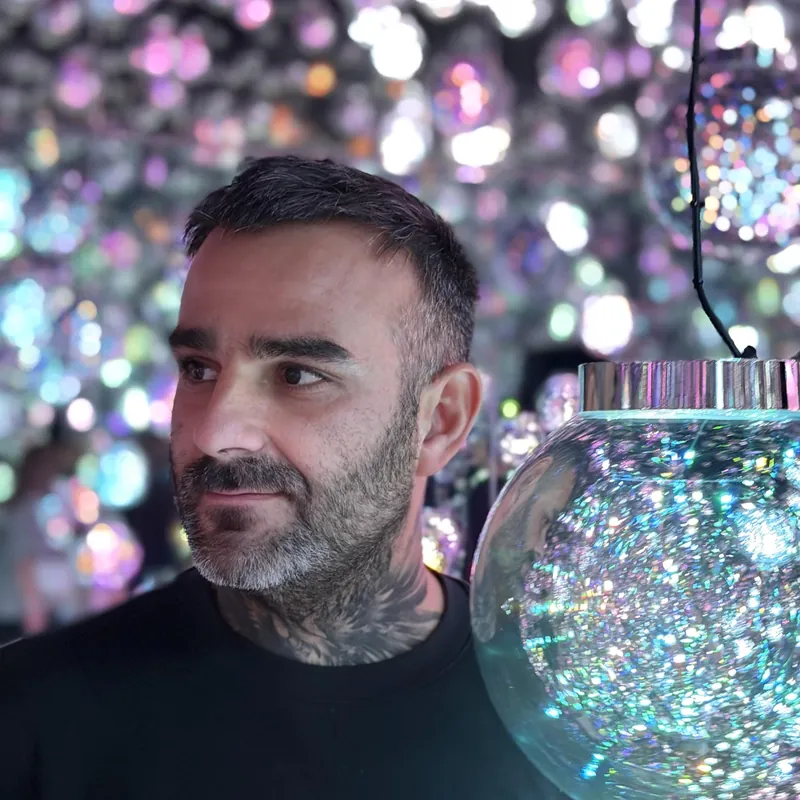
julien-jimenez-800.webp100 %
800 × 800·webp·Julien Jimenez, expert SEO technique
profil.ymlYAML
# profil.yml : aucune dépendance obsolète détectéerole: expert SEO indépendantsocle: [SEO, acquisition, édition web]
specialites: [crawl, logs, indexation, rendu, JSON-LD]
depuis: 2009langue: fr-FRzone: France et espace francophonemode: [à distance, sur site]
reponse: sous 48 h# en général
01 · whoami.md
$ whoami : Julien Jimenez, praticien du SEO technique
Julien Jimenez est un expert SEO français indépendant. Son socle tient en trois mots : référencement naturel, acquisition de trafic et édition web. Il pratique le référencement depuis 2009, selon le récit publié sur son site officiel, et il l’a appris sans recette toute faite : en créant ses propres sites, puis des dizaines de sites de test, sur lesquels il formule une hypothèse, la déploie et mesure ce qu’elle change réellement.
Le SEO technique est le terrain où cette culture du test sert le plus. Un robot n’a pas d’avis : il demande une URL, reçoit un code de statut, exécute ou non le JavaScript, retient une URL canonique. Chaque étape laisse une trace, dans les logs serveur, dans la Search Console ou dans le HTML rendu. Le travail consiste à lire ces traces, à isoler la cause, puis à proposer un correctif que votre équipe peut livrer.
Julien Jimenez intervient surtout sur des sites à fort volume de pages : catalogues e-commerce, médias, plateformes SaaS, applications construites avec React, Vue ou Next.js. Il parle le langage de vos développeurs (gabarits, déploiements, recette) comme celui de vos responsables produit (priorités, effort, impact). Il travaille partout en France et dans l’espace francophone, à distance ou sur site.
« Un excellent contenu ne performe que si les moteurs peuvent l’explorer, le rendre et l’indexer sans friction. »
Julien Jimenez
Ses pairs le décrivent avec leurs propres mots : plus bas, trois des quatorze recommandations LinkedIn qu’il a reçues de professionnels du SEO et du web sont reproduites telles quelles.
pipeline.svg5 étapes|flèches du clavier pour naviguer
02 · pipeline.svg
Du lien découvert à la page indexée : le pipeline expliqué
Entre le moment où Googlebot découvre une URL et celui où elle s’affiche dans les résultats, il y a cinq étapes. Chacune peut casser sans bruit. Ce schéma sert de carte : chaque module d’intervention de Julien Jimenez se situe sur l’une d’elles, et chaque diagnostic commence par identifier celle qui bloque.
Des liens de navigation rendus en <span onclick> ou en boutons : sans <a href>, il n’y a aucun lien à suivre.
Des sitemaps XML qui listent des URL redirigées, en erreur ou non canoniques.
Des pages orphelines : présentes dans le sitemap, absentes du maillage interne.
signal à vérifier
Le rapport Sitemaps de la Search Console, un crawl comparé au contenu des sitemaps, et la liste des URL vues dans les logs sans aucun lien interne.
menu.htmlligne type
<spanclass="lien"onclick="go('/guides/')">Guides</span><!-- aucun robot ne cliquera ici -->
02Exploration : le robot demande l’URL au serveur
ce qui casse souvent
Un Disallow trop large dans le robots.txt, qui bloque un répertoire entier ou les ressources CSS et JavaScript.
Des codes de statut HTTP incohérents : 200 sur une page introuvable (soft 404), 302 utilisée comme redirection permanente, erreurs 5xx intermittentes.
Un budget de crawlLe volume de requêtes qu’un moteur consacre à un site sur une période, selon la capacité du serveur et l’intérêt qu’il prête aux URL. dilué par des URL à paramètres, des facettes ou des calendriers sans fin.
signal à vérifier
Les logs serveur (fréquence de passage, codes renvoyés, temps de réponse) et le rapport Statistiques sur l’exploration de la Search Console.
robots.txtligne type
Disallow: /*?# bloque aussi /produit?id=42, seule URL de la fiche
03Rendu : le JavaScript s’exécute, en différé
ce qui casse souvent
Un contenu principal injecté uniquement côté client, après un appel d’API lent ou en échec.
Des ressources JavaScript bloquées par le robots.txt ou en erreur au moment du rendu.
Une hydratationL’étape où le JavaScript reprend la main sur un HTML déjà servi par le serveur pour le rendre interactif. qui remplace le title, la canonical ou la balise meta robots servis dans le HTML source.
signal à vérifier
L’inspection d’URL (HTML rendu et capture d’écran), puis un crawl avec rendu JavaScript comparé au même crawl sans rendu.
fiche.htmlligne type
<metaname="robots"content="noindex"><!-- retiré ensuite par le JS, mais déjà lu dans le HTML source -->
04Indexation : Google garde la page, ou non
ce qui casse souvent
Un meta robots noindex oublié après une mise en production.
Une balise canonical qui pointe vers une URL redirigée, en 404 ou contradictoire avec le sitemap.
Des gabarits pauvres ou quasi dupliqués, que Google classe en « Explorée, actuellement non indexée ».
signal à vérifier
Le rapport d’indexation des pages, et l’inspection d’URL pour comparer la canonique choisie par Google à celle que vous déclarez.
categorie.htmlligne type
<linkrel="canonical"href="https://www.example.com/ancienne-url/"><!-- répond 301 : signal contradictoire -->
05Affichage : la page apparaît dans les résultats
ce qui casse souvent
Un title réécrit par Google, parce qu’il est trop long ou identique sur tout un gabarit.
Des données structurées invalides ou incohérentes avec le contenu visible : aucun résultat enrichi.
Une meta description absente, remplacée par un extrait pris ailleurs dans la page.
signal à vérifier
Le test des résultats enrichis, les rapports d’amélioration de la Search Console et les performances par type de page.
schema.jsonligne type
"offers": { "@type": "Offer", "price": "" } // un prix vide n’enrichit aucun résultat
Rappel : les robots qui n’exécutent pas le JavaScript, dont une partie des robots d’IA, ne voient que le HTML source. Ce qui n’existe qu’après rendu n’existe pas pour eux : contenus, liens et balises essentiels doivent figurer dans la réponse du serveur.
modules/6 fichiers|combinables selon le symptôme
03 · modules/
Les modules d’intervention de Julien Jimenez
Six modules, que l’on combine selon le symptôme observé. Chacun produit des constats vérifiables et des correctifs rédigés comme des tickets, prêts à entrer dans votre backlog.
crawl.config.config
Crawl et architecture
Un crawl complet reconstitue le site tel qu’un robot le parcourt. On mesure la profondeur des pages stratégiques et ce qui les sépare de l’accueil.
Le but n’est pas d’indexer le plus de pages possible, mais les bonnes. On traque l’index bloatL’inflation de pages indexées sans valeur (filtres, paramètres, doublons) qui dilue l’exploration et la qualité perçue du site. et on aligne tous les signaux sur une seule URL.
Le JSON-LD décrit ce que la page affiche déjà, dans le vocabulaire schema.org que les moteurs comprennent. Il doit rester cohérent avec le contenu visible.
prérequis : les Core Web Vitals sont contrôlés à chaque diagnostic (LCP ≤ 2,5 s, INP ≤ 200 ms, CLS ≤ 0,1 au 75e centile). La performance est une condition de départ, pas l’angle de ce site.
access.logformat combined|lecture seule
04 · access.log
access.log : ce que Googlebot fait vraiment chez vous
La Search Console donne une vue agrégée et échantillonnée de l’exploration : utile pour repérer une tendance, insuffisante pour expliquer une anomalie. Les logs serveur, eux, enregistrent chaque requête réelle : l’adresse IP, l’heure, l’URL demandée, le code renvoyé, le poids de la réponse et le user-agent déclaré.
Une analyse de logs serveur répond à des questions précises. Quels gabarits Googlebot visite-t-il chaque jour, lesquels ignore-t-il depuis des semaines ? Quelle part des requêtes part dans des URL à paramètres sans valeur ? Quelles redirections et quelles erreurs sont encore servies aux robots ?
Julien Jimenez croise toujours les deux sources avant de conclure : la Search Console pour la tendance, les logs pour la preuve. Et il commence par écarter les faux Googlebot, sans quoi toute lecture du budget de crawl est faussée. Filtrez les lignes ci-dessous pour voir ce que chaque lecture révèle.
15 lignes · aucun filtre actifsurvol ou focus : défilement en pause
Lecture des lignes
Googlebot
La même URL à paramètres (couleur, tri, page) est explorée en boucle : du budget de crawl dépensé sur des variantes sans valeur propre.
à vérifier
Un user-agent Googlebot, mais une adresse hors des plages de Google, qui tente /wp-login.php puis /admin/ : un faux robot, à exclure avant toute statistique.
robots IA
GPTBot et ClaudeBot sont des robots d’IA distincts de Googlebot : on les compte à part, et leur accès se décide dans le robots.txt.
3xx
/ancienne-categorie/ renvoie une 301 vers /categorie-v2/, qui renvoie une autre 301 : une chaîne à ramener à un seul saut vers l’URL finale.
4xx
/produit-epuise-42/ répond 404 à chaque passage : la page est encore liée en interne, ce lien doit être corrigé ou redirigé.
ressources statiques
Scripts et images sont explorés aussi. Le code 304Not Modified : le serveur indique que le fichier n’a pas changé depuis la dernière visite, sans le renvoyer. évite de renvoyer un fichier inchangé : c’est un comportement sain.
verifier-googlebot.sh
$host66.249.66.12
12.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-12.googlebot.com.$hostcrawl-66-249-66-12.googlebot.com
crawl-66-249-66-12.googlebot.com has address 66.249.66.12# reverse puis forward : les deux réponses concordent, c’est bien Googlebot$host203.0.113.77
Host 77.113.0.203.in-addr.arpa not found: 3(NXDOMAIN)
# aucun nom en googlebot.com : faux Googlebot, ligne exclue
Vérifier un vrai Googlebot
Un user-agent se falsifie en une ligne. La vérification fiable se fait en deux temps : une requête reverse DNSRésolution inverse : on part de l’adresse IP pour obtenir le nom d’hôte déclaré par son propriétaire. sur l’adresse IP, qui doit aboutir à un nom en googlebot.com ou google.com, puis une requête DNS directe sur ce nom, qui doit renvoyer la même adresse.
Sur un gros volume de lignes, on compare plutôt chaque adresse aux plages d’adresses IP publiées par Google, puis on contrôle un échantillon à la main.
Quatre commits, toujours dans cet ordre. La méthode de Julien Jimenez n’a rien de secret : elle est appliquée sans sauter d’étape, sur chaque mission.
$ git log --methode --reverse
commit 3f2a9c1
diagnostiquer : mesurer avant d’agir
Crawl complet du site, échantillon de logs serveur, rapports d’indexation de la Search Console, inspection d’URL types, gabarit par gabarit. Aucune recommandation n’est écrite avant que le symptôme soit mesuré et sa cause isolée.
crawl
access.log
rapport d’indexation
inspection d’URL
commit 8b41e07
prioriser : impact et effort
Chaque recommandation reçoit une note d’impact et une note d’effort. Les constats sont regroupés par gabarit plutôt que page par page : corriger le modèle d’une fiche produit corrige d’un coup toutes les URL qui en dépendent.
impact
effort
par gabarit
commit c9d03fa
corriger : des tickets, pas un pavé
Chaque correctif est rédigé comme un ticket : contexte, constat, correctif attendu, critère de recette. Julien Jimenez travaille avec l’équipe de développement en place, dans ses outils et à son rythme de déploiement.
contexte
constat
correctif
recette
commit e17b6d2 HEAD -> main
contrôler : recette puis suivi
Recette en préproduction avant la mise en ligne, puis suivi des logs et des rapports d’indexation après le déploiement. Un correctif n’est considéré comme terminé que lorsque son effet est observé.
préproduction
logs
rapports
principes.tsnon négociables
/**
* Principes appliqués à chaque mission.
* Ils ne passent jamais en option.
*/// transparence : vous gardez vos données et vos accès// pédagogie : l’équipe comprend chaque correctif// et gagne en autonomie// durable : consignes de Google respectées,// aucune technique à risque// honnêteté : une mission inadaptée est refusée// dès le premier échange// aucune promesse chiffrée, aucune garantie de positionexport constraccourcis=null; // et c’est voulu
« Piloté par la donnée, pas par l’intuition. »
Julien Jimenez
fiche-produit.diffcas type fictif|5 corrections
06 · fiche-produit.diff
Avant, après : un gabarit corrigé en un seul diff
Un correctif technique se lit mieux qu’il ne se raconte. Voici un cas type, fictif : le gabarit d’une fiche produit tel qu’on le trouve souvent en audit, puis tel qu’il repart. Cinq lignes changent, et chacune modifie la façon dont les robots explorent ou indexent toutes les fiches qui en dépendent.
Hérité de l’environnement de test, il demandait à chaque fiche de rester hors de l’index. Sa suppression rend tout le gabarit indexable.
2
Une seule canonical, la bonne
Elle pointait vers la préproduction, en http et avec des paramètres. Elle désigne désormais l’URL finale en https, sans paramètre, cohérente avec le sitemap.
3
Un vrai lien dans le fil d’Ariane
Le span cliquable devient un lien a href : la catégorie est enfin découverte et reçoit le maillage depuis chaque fiche.
4
Un BreadcrumbList cohérent
Le JSON-LD décrit exactement le fil d’Ariane affiché : la page devient éligible à l’affichage de ce chemin dans les résultats.
5
Des dimensions sur l’image
Avec width et height, le navigateur réserve la place de l’image principale : la mise en page ne saute plus pendant le chargement.
// exemple pédagogique : aucun site réel, aucun résultat chiffré annoncé.
CHANGELOG.mdgit tag --list|repères vérifiables
07 · CHANGELOG.md
Historique des versions : le parcours de Julien Jimenez
Un historique volontairement court, limité aux repères vérifiables. Pas de version inventée, pas de date approximative : ce qui n’est pas daté reste sur une branche.
v20092009
Premier commit : les débuts
Débuts dans le référencement, sur ses propres sites puis sur des dizaines de sites de test. Tout part de là : une hypothèse, un test, une mesure, et l’on recommence.
source : récit de son site officiel
··· lignes masquées : tests, mesures, itérations
v20122012
Concours SEO « Sentimancho »
Troisième place au concours SEO « Sentimancho » : un terrain d’expérimentation public, avec un classement pour seul juge.
feat/netlinkingau fil des années
Une plateforme de netlinking
Conception d’une plateforme de netlinking utilisée par plus de 20 000 sites, et plus de 2 millions de liens orchestrés. Ce sont des repères de parcours, pas des références clients.
source : son site officiel
v20162016
Premières conférences
Premières interventions dans des événements SEO francophones, pour partager ce que les tests ont appris et confronter les méthodes à celles des pairs.
feat/discoverspécialité signature
Google Discover et la formation « Disco »
Google Discover devient sa spécialité : choix des sujets, signaux d’entrée dans le flux, indexation, rythme de publication, une méthode éprouvée sur ses propres sites. Il crée la formation « Disco », consacrée à ce canal.
v20232023 · Nantes
Webisland, à Nantes
Intervention à Webisland sur le thème « La ténacité au service de la passion » : l’état d’esprit et la persévérance qu’exige le référencement dans la durée.
HEADaujourd’hui
SEO technique, notes publiées ici latest
Le SEO technique au quotidien : crawl, logs, indexation, rendu et données structurées. Des notes techniques publiées sur ce site, et 14 recommandations LinkedIn de professionnels du SEO et du web.
constantes.tsreadonly|6 valeurs sourcées
08 · constantes.ts
const : les chiffres clés de Julien Jimenez
Des valeurs fixes, sourcées, sans arrondi flatteur. Elles s’incrémentent à l’écran comme une variable inspectée dans un débogueur, puis ne bougent plus.
numberconstdebut=2009// plus de quinze ans de pratique du référencement
stringconstsitesPlateforme=20 000+// sites ayant utilisé la plateforme de netlinking qu’il a conçue
stringconstliensOrchestres=2 M+// plus de 2 millions de liens orchestrés au fil des années
stringconstpodium=3e// concours SEO Sentimancho, en 2012
numberconstrecommandations=14// recommandations LinkedIn de professionnels du SEO et du web
stringconstdelaiReponse=48 h// délai de réponse habituel à un premier e-mail, en général
// repères techniques publics : redirections 301 en un seul saut · title de 50 à 65 caractères · meta description de 140 à 160 caractères · images d’au moins 1 200 px de large et max-image-preview:large pour Google Discover.
review.md3 approbations|texte intégral
09 · review.md
Code review : ce qu’en disent les pairs
approved3 des 14 recommandations LinkedIn reçues par Julien Jimenez, reproduites mot pour mot, avec le nom et la fonction de leur auteur.
JP
Jeremy ParolaDirecteur des activités numériques, Reworld Media
approved
« Julien est un des plus grands experts SEO en France. Nous avons collaboré à plusieurs reprises sur des sujets relatifs à Google et Google Discover. Il a une connaissance extrêmement fine des algorithmes. Il sait expliquer par la preuve et la démonstration, ce qui rend extrêmement concrètes ses recommandations. Il est certainement l’un des meilleurs experts du marché français (européen ?). Je recommande. »
recommandation LinkedIn publique · 1 / 3
SM
Stéphane MadalenoFondateur de l’agence SEE U BETTER, créateur d’outils SEO
approved
« Si vous cherchez un expert qui maîtrise réellement les rouages du SEO et de Google Discover, ne cherchez plus. J’ai partagé la scène avec Julien lors de deux conférences et son niveau technique est tout simplement exceptionnel. Sa capacité à générer du trafic via Discover est une référence dans le milieu. Curieux et toujours à l’affût, il apporte une vision stratégique qui fait la différence. Je recommande Julien sans aucune hésitation pour quiconque souhaite passer un cap sérieux avec son business. »
recommandation LinkedIn publique · 2 / 3
FR
Franck RobichonConsultant en stratégie informatique & Formateur
approved
« J’ai eu à plusieurs reprises l’occasion de travailler pour Julien et ses équipes. Précis, méticuleux, Julien transperce d’intelligence. Nul ne pourra dire qu’il ne respecte pas une parole donnée. Depuis presque 10 ans que je le connais, c’est quelqu’un qui a surmonté bien des épreuves avec une sorte de sagesse et beaucoup d’humilité. En SEO, en stratégie web et Discover, c’est un tueur ! L’enfant terrible du SEO francophone, c’est lui. Je recommande chaudement Julien pour tous ces domaines. »
Des notes de terrain écrites comme une documentation interne : un problème précis, la façon de le diagnostiquer, les commandes et rapports à consulter, puis les correctifs à prioriser.
verifier-vrai-googlebot-logs-serveur.md
--- date: 2026-06-09 categorie: Logs serveur lecture: 12 min ---
Le user-agent ne prouve rien. Voici la procédure complète pour isoler les vraies visites de Googlebot, de la double vérification DNS jusqu’à l’automatisation sur un gros volume de lignes.
ouvrir la note
exploree-actuellement-non-indexee-que-faire.md
--- date: 2026-08-27 categorie: Indexation lecture: 12 min ---
Ce statut n’est pas toujours un problème. Une grille de tri pour séparer les cas normaux des vrais blocages, puis décider : améliorer, fusionner, désindexer ou attendre.
ouvrir la note
tester-rendu-javascript-googlebot.md
--- date: 2026-10-07 categorie: Rendu JavaScript lecture: 12 min ---
HTML source contre DOM rendu, inspection d’URL, crawl avec et sans rendu : un protocole de test reproductible, et une check-list à rejouer avant chaque mise en production.
Les questions qui reviennent le plus souvent, avec des réponses courtes et vérifiables. Pour un cas précis, le plus simple reste d’écrire directement.
terminal
$grep-c"question:" faq.yml
9# la dixième arrive par e-mail
01Qu’est-ce que le SEO technique, concrètement ?··· 4 lignes
C’est l’ensemble des réglages qui permettent aux moteurs de découvrir, d’explorer, de rendre et d’indexer vos pages : architecture des liens, robots.txt, sitemaps XML, codes de statut HTTP, balise canonical, rendu JavaScript, données structurées, hreflang. Le SEO technique ne remplace ni le contenu ni la popularité. Il évite que ce travail soit perdu en route, car une page que Google n’explore pas ou n’indexe pas ne peut pas se positionner.
02Pourquoi analyser les logs serveur alors que la Search Console existe ?··· 4 lignes
Parce que les deux sources ne répondent pas à la même question. La Search Console présente une vue agrégée et échantillonnée de l’exploration, sur un historique limité. Les logs serveur enregistrent chaque requête réelle, URL par URL, avec le code renvoyé et le user-agent. Ils montrent ce que Googlebot visite, ce qu’il ignore et où il gaspille ses passages. Julien Jimenez croise les deux sources avant de conclure.
03Le budget de crawl concerne-t-il un site de quelques centaines de pages ?··· 4 lignes
Rarement. Sur un site de quelques centaines de pages bien liées, Google explore en général tout sans difficulté. Le budget de crawl devient un sujet sur les sites à fort volume, ou dès qu’un site génère des URL en masse : facettes, paramètres de tri, calendriers, moteur de recherche interne. Sur un petit site, les blocages viennent plus souvent d’un noindex, d’une canonical erronée ou d’un maillage insuffisant.
04Google indexe-t-il correctement un site construit avec React ou Next.js ?··· 4 lignes
Oui, Google sait exécuter le JavaScript, mais le rendu intervient en différé et peut échouer si une ressource est bloquée ou une API trop lente. Le risque dépend surtout de la stratégie de rendu. Avec Next.js en rendu serveur ou en génération statique, le HTML source contient déjà l’essentiel. En rendu client seul, il faut vérifier, gabarit par gabarit, que contenus, liens et balises existent bien après rendu.
05Les données structurées font-elles monter une page dans les résultats ?··· 4 lignes
Pas directement, et elles ne garantissent aucune position. Les données structurées rendent une page éligible à certains résultats enrichis, comme le fil d’Ariane, la fiche produit ou l’article, et clarifient pour les moteurs la nature du contenu. Elles doivent décrire ce que la page affiche réellement : un balisage incohérent avec le contenu visible est ignoré et peut même faire l’objet d’une action manuelle.
06Que faire quand des pages restent « Explorée, actuellement non indexée » ?··· 4 lignes
D’abord, vérifier qu’il s’agit d’un problème : ce statut signifie que Google a exploré la page et choisi de ne pas l’indexer pour l’instant. On constitue un échantillon d’URL, on les inspecte une à une, puis on trie : pages faibles ou quasi dupliquées à améliorer ou à fusionner, URL sans valeur à désindexer, vrais problèmes de rendu ou de canonical à corriger. Le reste se surveille.
07Julien Jimenez travaille-t-il avec l’équipe de développement en place ?··· 4 lignes
Oui, c’est même la règle. Il ne remplace ni vos développeurs ni votre agence : il leur fournit des constats documentés et des correctifs rédigés comme des tickets, avec un critère de recette. Il s’adapte à vos outils, à votre rythme de déploiement et à vos contraintes techniques, répond aux questions pendant l’implémentation et contrôle le résultat en préproduction. Vous gardez vos données, vos accès et la maîtrise de votre code.
08Combien de temps avant de voir l’effet des correctifs techniques ?··· 4 lignes
Cela dépend de la fréquence à laquelle Google explore les pages concernées et de l’ampleur du correctif. Un changement sur un gabarit très exploré se lit souvent vite dans les logs ; la réindexation d’un grand catalogue prend nettement plus longtemps. Aucune promesse de délai ni de résultat n’est faite : on suit l’effet réel dans les logs et les rapports d’indexation, puis on ajuste.
09Comment démarrer un diagnostic technique avec Julien Jimenez ?··· 4 lignes
Écrivez à jimenezjulien42@gmail.com en indiquant l’URL du site, le CMS ou le framework utilisé, le symptôme constaté et, si possible, un extrait de logs. Julien Jimenez répond généralement sous 48 heures. Le premier échange sert à qualifier le besoin : si un diagnostic technique est utile, il vous propose un périmètre ; sinon, il vous le dit franchement.
contact.shaucun formulaire|un e-mail, lu par une personne
Pas de formulaire, pas de prise de rendez-vous automatisée : un e-mail, lu par Julien Jimenez lui-même. Décrivez le symptôme comme vous le décririez dans un ticket, avec ce que vous avez déjà observé.
Il intervient partout en France et dans l’espace francophone, à distance ou sur site, en lien direct avec vos équipes techniques et produit.